Auf einen Blick
Microsoft 365 war ab Donnerstag, 18.30 Uhr mitteleuropäischer Zeit, weitgehend gestört. Der Datenverkehr des E-Mail-Dienstes Exchange brach auf noch 15 Prozent des erwarteten Volumens ein; auch Teams, Sharepoint und der KI-Assistent Copilot funktionierten nur eingeschränkt.
Ausgelöst wurde die Störung offenbar durch eine Änderung in der Netzwerkkonfiguration und einen fehlerhaften automatischen Zustandscheck der Server. Sie steht laut Microsoft nicht im Zusammenhang mit einem Cyberangriff oder mit KI-Agenten.
Die Wiederherstellung dauerte bis Freitagmittag. Microsoft entschuldigte sich und will einen umfassenden Bericht vorlegen. Der Vorfall zeigt, wie abhängig Organisationen weltweit von einzelnen Cloud-Anbietern sind.
Achtzehn Stunden Poststau
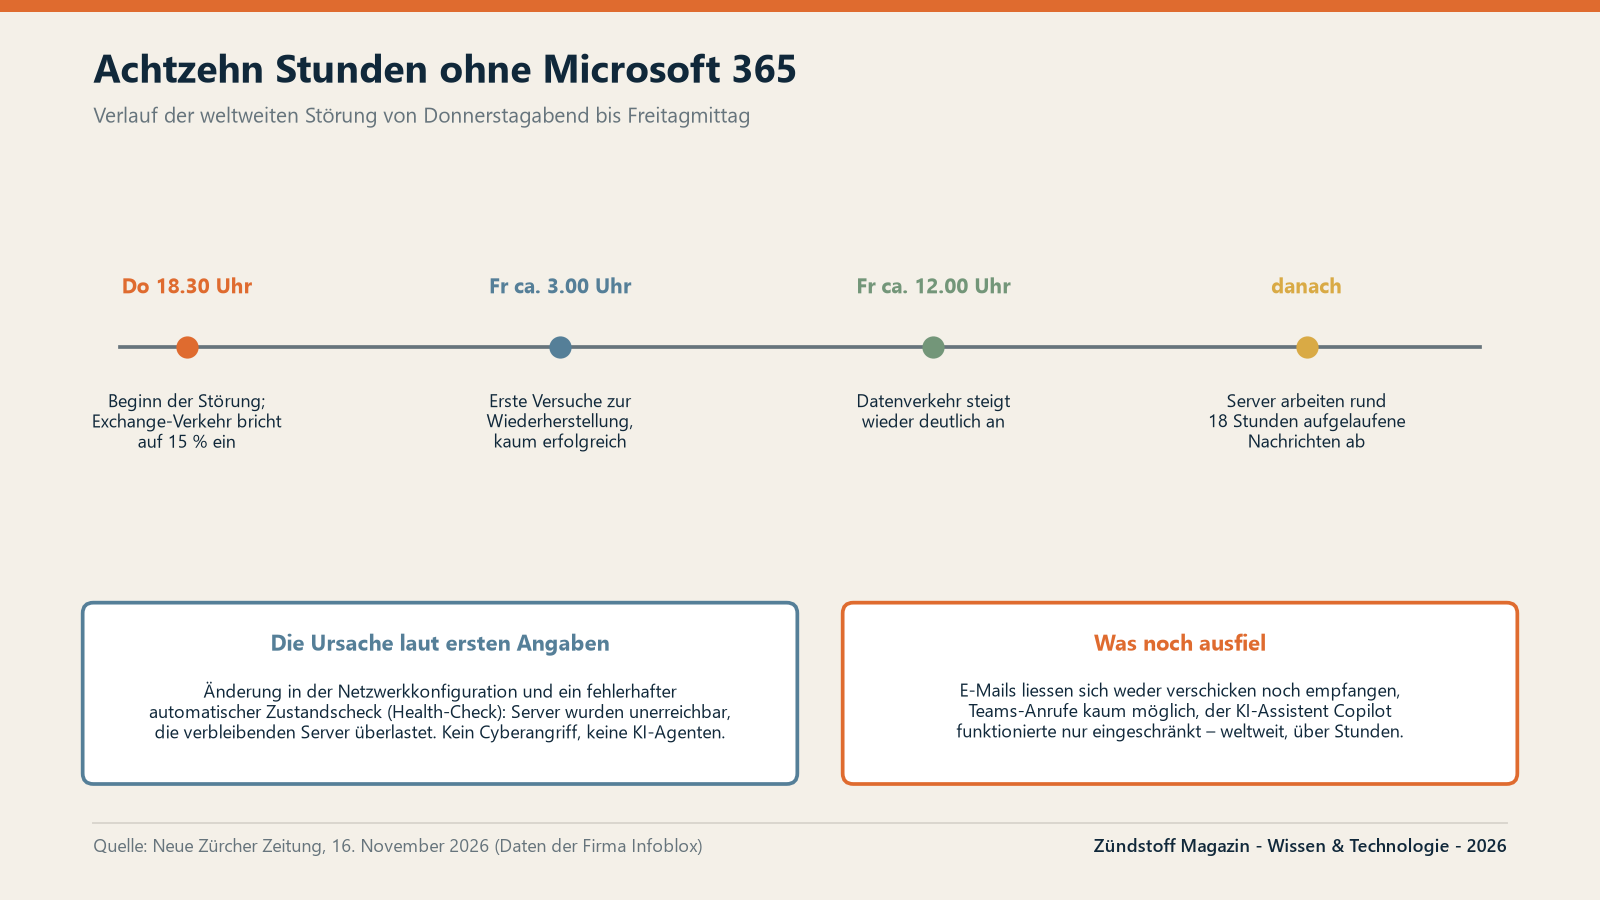
Die Ausgangslage ist nüchtern dokumentiert. Begonnen hatte die Störung am Donnerstag um 18 Uhr 30 mitteleuropäischer Zeit. Der Datenverkehr des E-Mail-Dienstes Exchange brach fast komplett zusammen, auf noch 15 Prozent des erwarteten Volumens. Das zeigen Daten der Firma Infoblox, die weltweit die Datenflüsse im Internet beobachtet. Andere Dienste wie die Telefonieanwendung Teams oder der Datenaustausch Sharepoint verzeichneten ebenfalls einen Rückgang, der jedoch weniger stark ausfiel.
In der Nacht auf Freitag, etwa um 3 Uhr, stieg der Verkehr leicht an – die ersten Versuche zur Wiederherstellung, die noch kaum Erfolg hatten. Erst am Freitag gegen 12 Uhr stieg der Datenverkehr wieder deutlich an. Doch auch das bedeutete keinen Normalbetrieb: Die E-Mail-Server mussten zuerst die über rund achtzehn Stunden aufgelaufenen Nachrichten abarbeiten, die weder versendet noch empfangen werden konnten.
Die Störung trat nicht flächendeckend auf. Nicht alle Firmen waren mit einem kompletten Ausfall konfrontiert; Teams war erst verzögert betroffen und nie im selben Ausmass wie Exchange. Bei gewissen Rechenzentren war zwischendurch ein eingeschränkter Datenverkehr möglich.
Was bereits geschieht
Ausgelöst wurde die Störung laut ersten Angaben offenbar durch eine Änderung in der Netzwerkkonfiguration. Eine automatische Routine, welche den Zustand der Server überprüft – ein sogenannter Health-Check –, war offenbar fehlerhaft. Weil die Server diesen Check nicht bestanden, waren sie nicht mehr erreichbar. Diese Ausfälle führten dazu, dass die verbleibenden Server überlastet wurden.
Microsoft teilte am Freitagabend mit, die Störung stehe nicht im Zusammenhang mit einem Cyberangriff oder mit KI-Agenten. Das Unternehmen versuchte, den Datenverkehr auf andere Rechenzentren umzuleiten – was möglicherweise an anderen Orten ebenfalls zu einer Überlastung führte. Hinzu kam das Verhalten der Nutzer selbst: Nachdem die Störung begonnen hatte, nahmen die Verbindungsversuche zu, weil Kunden vermehrt auf ihre Dienste zuzugreifen versuchten. Das erzeugte zusätzlichen Datenverkehr und erschwerte die Wiederherstellung möglicherweise noch.
Schon hier zeigt sich eine erste Form der Aufgabenteilung. Das System überwacht sich selbst, ordnet Server ab und schwenkt Verkehr um. Menschen suchen den Fehler und entscheiden, wann sie Server wieder zuschalten. Aber was passiert, wenn die Selbstüberwachung der Fehler ist?
Vom Werkzeug zur Voraussetzung
Damit verschiebt sich der Blick auf den Vorfall. Er ist nicht nur eine Betriebsstörung, sondern ein Fenster auf eine Verschiebung: E-Mail, Telefonie, Dateien und zunehmend auch KI-Assistenten wie Copilot laufen über dieselbe Infrastruktur. Der Ausfall eines Dienstes ist heute der Ausfall des Arbeitstags.
Die Wiederherstellung selbst verlief nach einem bewusst langsamen Muster. Die Techniker mussten zuerst das Problem ausfindig machen und eine Lösung für die fehlerhafte Zustandsprüfung finden. Indem sie Datenverkehr umleiteten oder teilweise blockierten, konnten sie die Situation regional stabilisieren. Danach schalteten sie die Server schrittweise wieder auf und überprüften jeweils die Stabilität. So habe die Wiederherstellung zwar länger gedauert, schreibt Microsoft, sei jedoch stabiler verlaufen. Das Unternehmen entschuldigte sich am Freitagabend bei seinen Kunden und will nach Abschluss der Untersuchung einen umfassenden Bericht über den Vorfall vorlegen.
Drei Stufen der Abhängigkeit
Der Umgang mit solchen Cloud-Diensten lässt sich in Stufen beschreiben. Erste Stufe: Das System informiert – es speichert Mails und Dateien, so wie ein Archiv, das man bei Bedarf aufsucht. Zweite Stufe: Es vermittelt – es verbindet Anrufe, Sitzungen und Kalender, so wie eine Telefonzentrale, ohne die kein Draht mehr funktioniert. Dritte Stufe: Es arbeitet mit – der KI-Assistent fasst zusammen, schlägt Antworten vor, bereitet vor. Fällt die Infrastruktur aus, schweigen alle drei Stufen gleichzeitig.
Automatische Reaktionen sind nicht neu. Der Sprinkler löst bei Hitze aus, die Schranke senkt sich vor dem Bahnübergang. Neu ist die Reichweite: Ein einzelner fehlerhafter Zustandscheck in einer Netzwerkkonfiguration kann den Arbeitsalltag von Organisationen auf mehreren Kontinenten gleichzeitig unterbrechen.
Vier Fragen an jede Auslagerung
Damit lässt sich jede Abhängigkeit von Cloud-Diensten an einem kleinen Raster messen. Welche Arbeitsvorgänge stehen still, wenn der Anbieter ausfällt – und welche laufen weiter? Wer erfährt wie schnell, warum die Systeme nicht mehr antworten? Welche Nachrichten, Termine und Entscheide warten im Stau, und in welcher Reihenfolge werden sie nachgeholt? Und bei welchen Aufgaben wäre ein lokaler Notbetrieb – ein Telefon, ein Protokoll auf Papier – überhaupt noch möglich?
Die Störung zeigt, wie abhängig Unternehmen und Organisationen weltweit von Microsoft sind. Gleichzeitig ist die technische Infrastruktur hinter diesen Cloud-Diensten so komplex und vernetzt, dass ein einzelner Fehler zu langen und weitreichenden Ausfällen führen kann.
Die unsichtbare Leitung
Vielleicht verläuft die entscheidende Grenze nicht zwischen digitaler und analoger Arbeit. Vielleicht liegt sie zwischen Aufgaben, für die man ein Werkzeug nutzt, und Aufgaben, deren Voraussetzung das Werkzeug längst geworden ist – und darin, ob diese Abhängigkeit sichtbar bleibt, bevor sie ausfällt.
Welche Abläufe möchten wir auch bei einem mehrtägigen Ausfall noch selbst tragen können? Welche Daten möchten wir beschleunigt austauschen – und welche gar nicht erst in fremden Rechenzentren lagern? Und bei welchen Entscheiden wollen wir wissen, auf wessen Infrastruktur sie eigentlich beruhen?