Auf einen Blick
Ein Benchmark verbindet Aufgaben mit einer Auswertungsregel. Er misst Leistung unter festgelegten Bedingungen, nicht eine allgemeine «Intelligenz». [1, 2]
Kleine Änderungen können Ränge verschieben. Bei einem verbreiteten Multiple-Choice-Test veränderten Antwortreihenfolge und Auswertungsmethode Positionen um bis zu acht Plätze. [4]
Für einen Einsatzentscheid braucht es deshalb eigene Fälle, Fehlergrenzen, Kosten, Geschwindigkeit, Datenschutz und menschliche Kontrolle. [1, 6, 8]
Eine Zahl entsteht
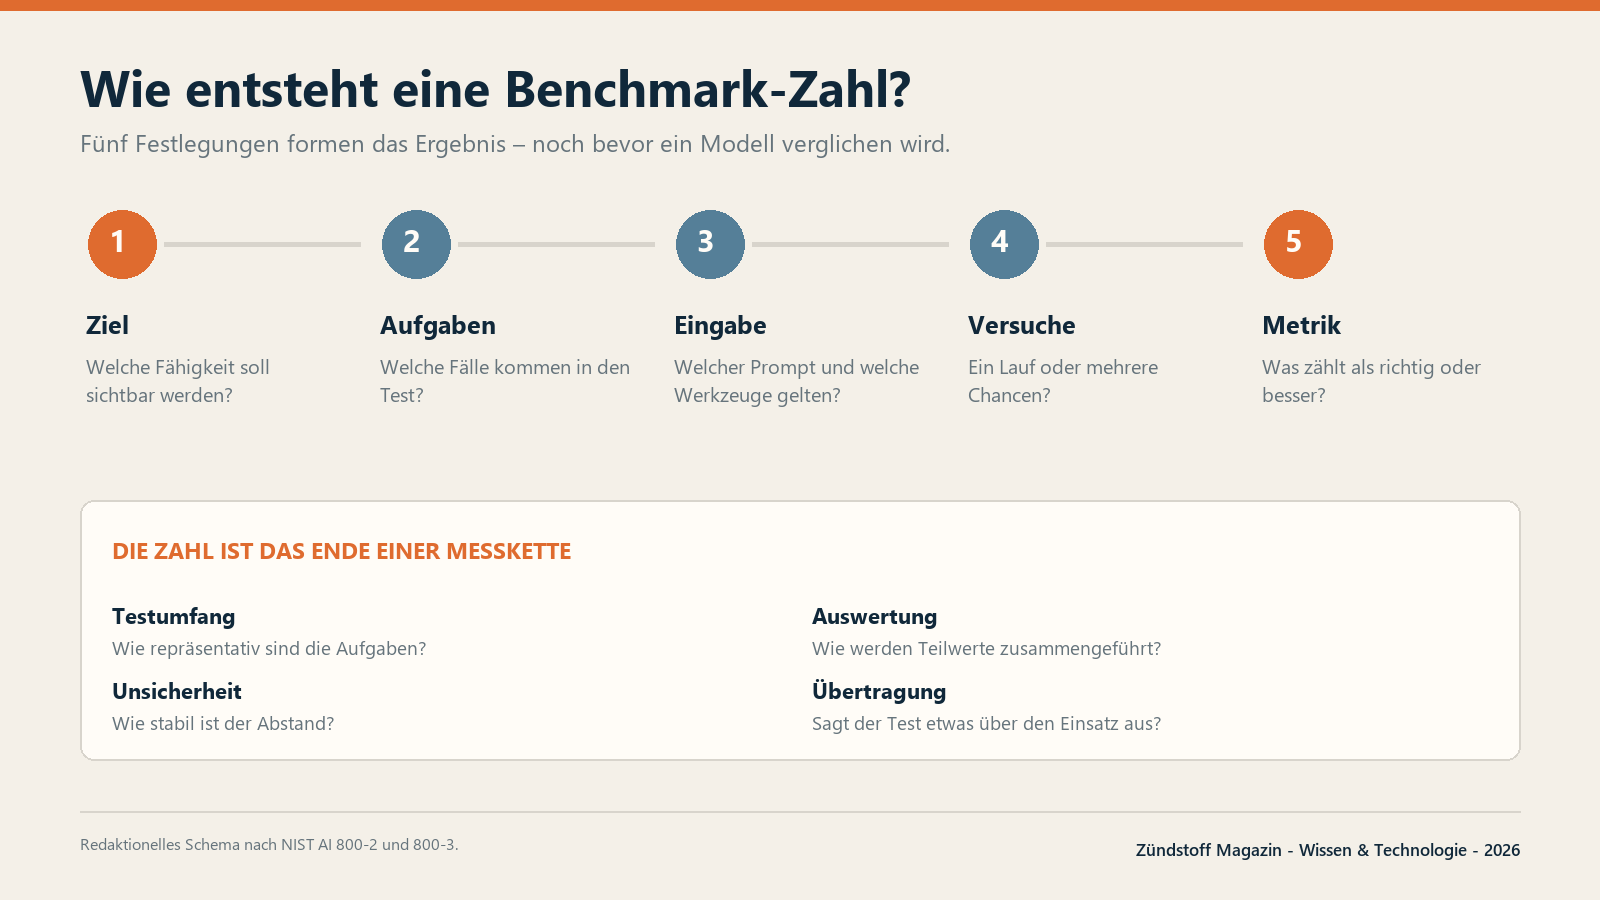
Ein Benchmark beginnt nicht mit einem Modell, sondern mit einer Frage. Soll Wissen, Programmieren, Zusammenfassen oder das Befolgen von Anweisungen geprüft werden? Danach werden Aufgaben ausgewählt, Eingaben formuliert und Regeln festgelegt. Erst am Ende entsteht eine Zahl.
NIST beschreibt einen Benchmark als Verbindung von Datensatz und Metrik, die für eine bestimmte Aufgabe oder Fähigkeit stehen soll. Oft misst der Test jedoch nur eine Stellvertreteraufgabe. Ob daraus ein Ergebnis im Alltag folgt, muss zusätzlich begründet werden. Ein Modell kann beispielsweise kurze Programmieraufgaben lösen, ohne ein monatelanges Softwareprojekt verlässlich zu führen. [1, 2]
Schon hier zeigt sich eine erste Form der Aufgabenteilung. Der Test macht Antworten vergleichbar. Menschen entscheiden, welche Aufgaben zählen und welche Abweichung akzeptabel ist. Aber wie sichtbar bleiben diese Festlegungen, wenn am Ende nur eine Rangzahl erscheint?
Der Rang ist beweglich
Die Rangfolge kann auf Details reagieren, die mit dem späteren Einsatz wenig zu tun haben. Eine ACL-Studie veränderte bei Multiple-Choice-Aufgaben unter anderem die Reihenfolge der Antwortmöglichkeiten und die Auswahlmethode. Modelle verschoben sich dadurch um bis zu acht Plätze. [4]
Auch die Zahl der Versuche verändert die Aussage. Pass@1 fragt, ob der erste Versuch gelingt. Pass@10 erlaubt mehrere Anläufe. Beide Werte können korrekt sein und dennoch verschiedene Arbeitsweisen beschreiben. Ein Chatbot für Bürgeranfragen erhält vielleicht eine Chance. Ein Entwicklungssystem darf mehrere Entwürfe erzeugen und automatisch testen.
Ein weiterer Hinweis ist die Sättigung. Wenn leistungsfähige Systeme fast alle Aufgaben lösen, werden kleine Abstände gross dargestellt, obwohl der Test kaum noch trennt. Neue, schwerere Aufgaben können die Reihenfolge verändern. Ein alter Spitzenwert bleibt damit eine historische Messung, keine dauerhafte Eigenschaft des Modells. [1]
Hinzu kommt die Unsicherheit. NIST warnt davor, verschiedene Vorstellungen von Leistung in einem Durchschnitt zusammenzuziehen oder Fehlerbereiche zu eng anzugeben. Liegen zwei Systeme nahe beieinander, kann der sichtbare Abstand kleiner sein als die Unsicherheit der Messung. [2]
Sieben Seiten der Leistung
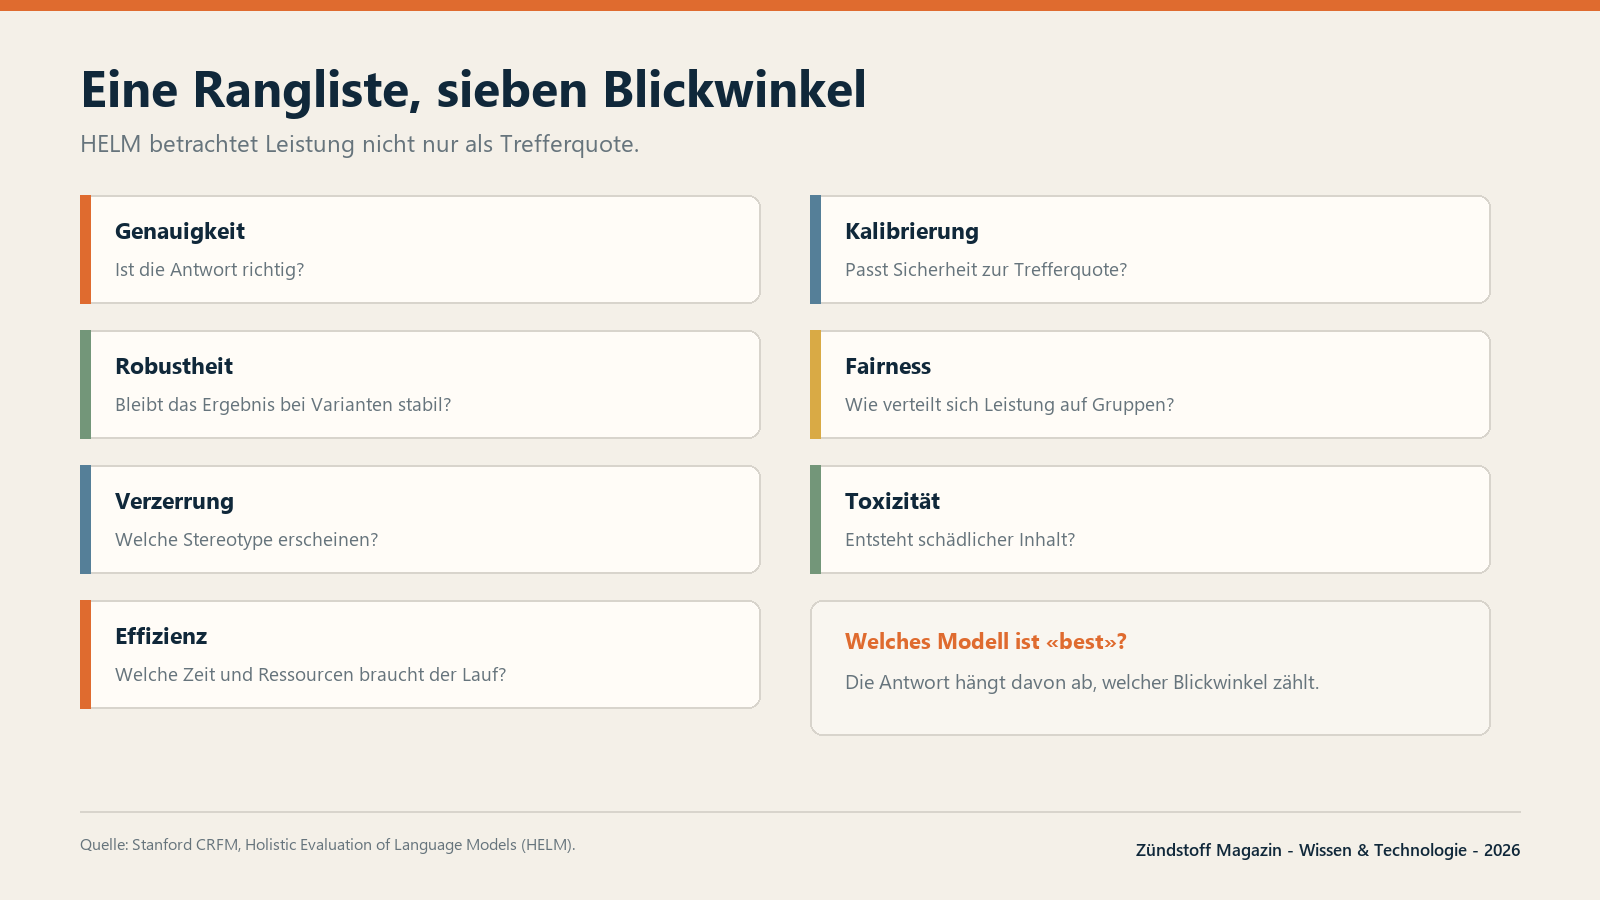
Stanford entwickelte HELM, um Modelle über mehrere Szenarien und Messgrössen transparent zu vergleichen. Neben Genauigkeit berücksichtigt das Rahmenwerk Kalibrierung, Robustheit, Fairness, Verzerrung, Toxizität und Effizienz. Die einzelnen Eingaben und Antworten bleiben einsehbar. [3]
Damit verschiebt sich die Frage. Nicht «Welches Modell ist das beste?» entscheidet über die Auswahl, sondern «Welche Eigenschaft braucht diese Aufgabe?» Ein günstiges System kann für interne Entwürfe genügen. Bei rechtlich relevanten Schreiben können Nachvollziehbarkeit und Fehlerkontrolle schwerer wiegen als Tempo.
In diesen Vergleichen ersetzt die Rangliste keine Fachperson. Sie ordnet Ergebnisse, macht Unterschiede sichtbar und kann ungeeignete Kandidaten aussortieren. Die Gewichtung bleibt eine Entscheidung über den konkreten Einsatz.
Menschen wählen anders
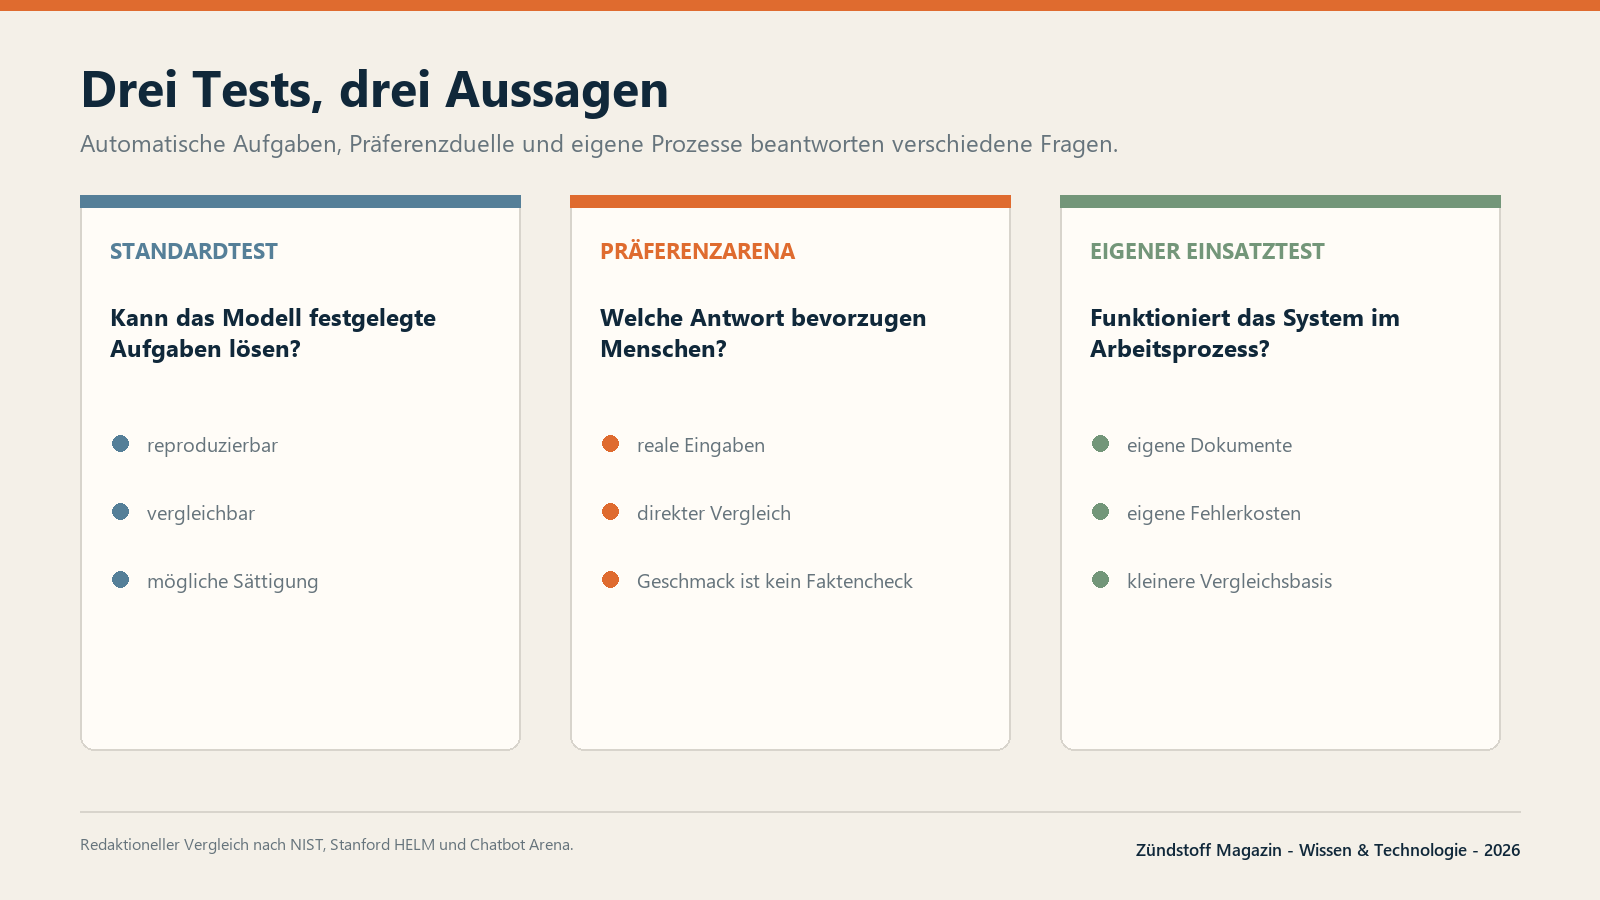
Automatische Tests prüfen Lösungen gegen festgelegte Regeln. Präferenzarenen stellen dagegen zwei Antworten nebeneinander und lassen Menschen wählen. Die Chatbot Arena zeigte, dass solche Urteile in grosser Zahl stabile Vergleiche ermöglichen und mit Expertenurteilen übereinstimmen können. [5]
Doch eine Präferenz ist kein vollständiger Faktencheck. Eine klare, höfliche oder ausführliche Antwort kann gefallen, obwohl eine entscheidende Angabe fehlt. Umgekehrt kann eine knappe, fachlich richtige Antwort schlechter wirken. Menschliche Wahl misst, was Menschen in der jeweiligen Situation bevorzugen.
Ein dritter Prüfstand entsteht erst im eigenen Betrieb. Dort zählen eigene Dokumente, Fachbegriffe, Sprachen, Ausnahmen und Fehlerfolgen. Standardtest, Präferenzduell und Anwendungstest widersprechen sich nicht. Sie beobachten verschiedene Ausschnitte.
Vom Labor in den Arbeitsprozess
Statische Tests können altern. Aufgaben werden bekannt, Modelle werden darauf abgestimmt oder Testdaten gelangen in Trainingsmaterial. NIST verlangt deshalb, mögliche Überschneidungen zu dokumentieren und Benchmarks auf den Nutzungskontext zu beziehen. [1, 6]
Wie schwer faire Aufgaben zu pflegen sind, zeigt ein aktueller Fall aus der Softwareentwicklung. OpenAI überprüfte SWE-Bench Pro und berichtet, dass die menschliche Kontrolle 249 von 731 Aufgaben als fehlerhaft identifizierte. Zu strenge Tests, unvollständige Aufgabenbeschreibungen und schwache Testabdeckung konnten richtige Lösungen abwerten oder unvollständige Lösungen bestehen lassen. [7]
Das Beispiel stammt von einem Modellanbieter und braucht diese Einordnung. Es zeigt dennoch ein allgemeines Problem: Wenn die Messlatte Fehler enthält, wird auch eine präzise Rangliste präzise am falschen Gegenstand ausgerichtet.
Der eigene Prüfstand
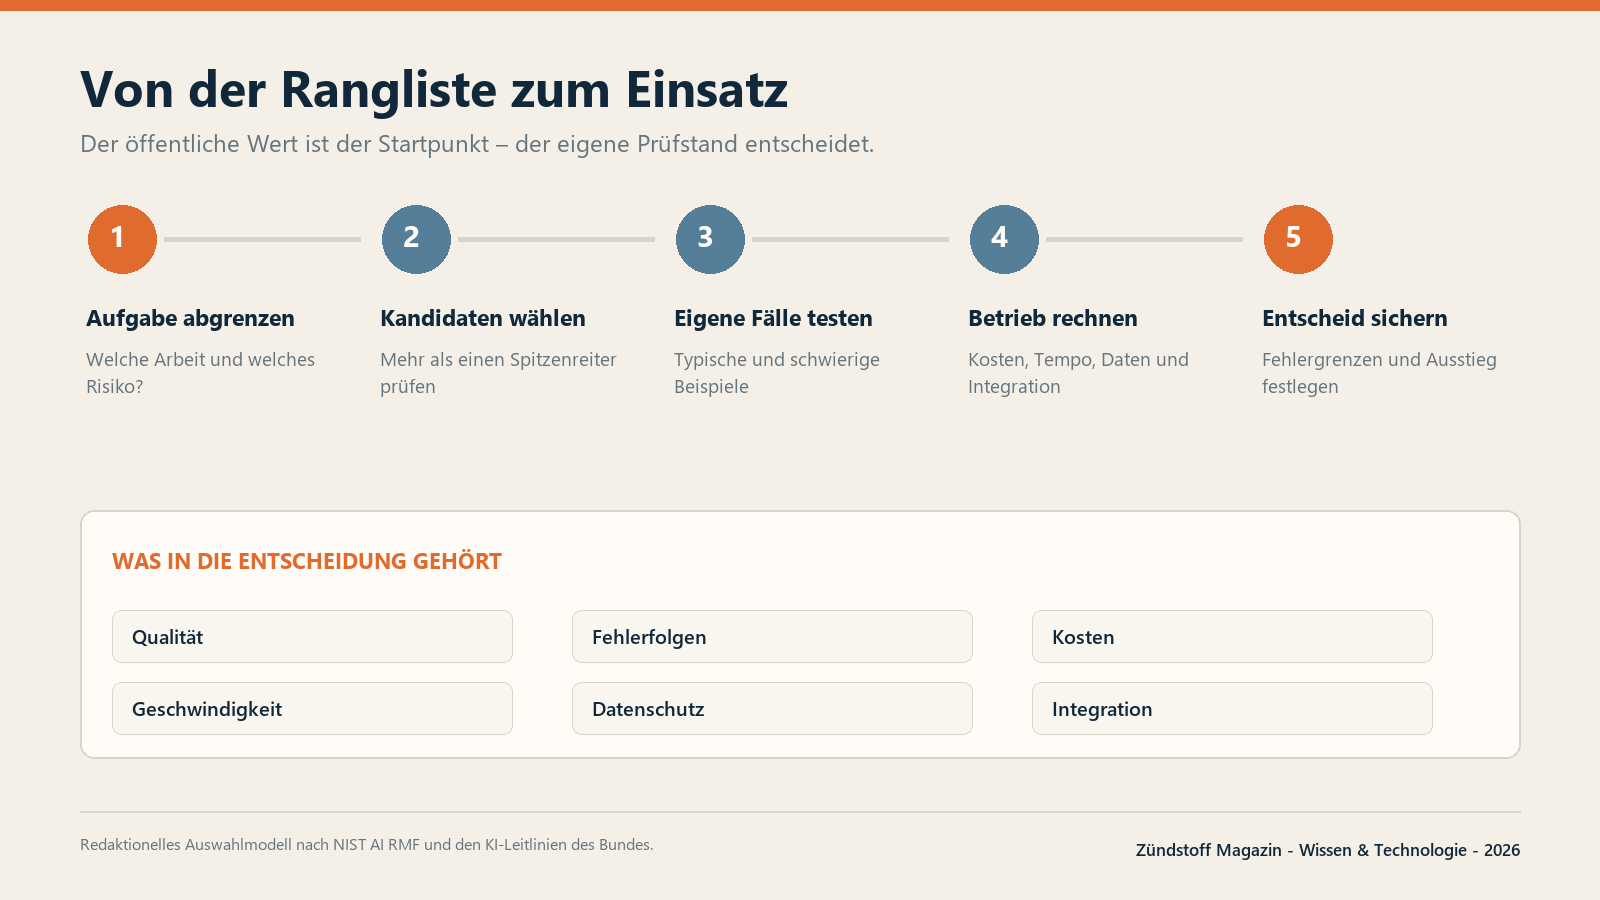
Für Unternehmen und Behörden beginnt die Auswahl deshalb mit dem Arbeitsprozess. Welche Dokumente kommen vor? Welche Sprachen und Sonderfälle? Welche Fehler lassen sich korrigieren, welche greifen in Rechte oder Zahlungen ein? Aus diesen Fragen entsteht ein kleiner, geschützter Testsatz mit typischen und schwierigen Fällen.
Der Vergleich braucht zudem eine Ausgangslage. Wie lange benötigt ein Mensch heute, wie häufig entstehen Fehler und welche Nacharbeit fällt an? Erst diese Basis zeigt, ob ein besserer Modellwert tatsächlich Zeit spart oder nur Arbeit verschiebt. Ein System, das häufiger kontrolliert werden muss, kann trotz tiefer Nutzungskosten teurer werden.
Dann werden mehrere Systeme unter denselben Bedingungen geprüft. Qualität, Fehlerarten, Kosten und Geschwindigkeit gehören zusammen. Ebenso wichtig sind Datenstandort, Zugriffskontrolle, Integration, Protokollierung und die Möglichkeit, das System zu wechseln. Die KI-Strategie des Bundes verlangt Nutzen, Rechtskonformität, Transparenz und menschliche Verantwortung. Eine öffentliche Rangliste deckt diesen Rahmen nicht allein ab. [8]
Ein einmaliger Test reicht ebenfalls nicht. Modelle, Datenquellen und Schnittstellen ändern sich. Wer ausgewählte Prüffälle regelmässig wiederholt und Vorfälle aus dem Betrieb ergänzt, macht aus der Rangliste eine fortlaufende Qualitätskontrolle. So bleibt auch sichtbar, wann ein vermeintlicher Fortschritt an einer wichtigen Stelle einen Rückschritt verursacht.
Vielleicht verläuft die entscheidende Grenze nicht zwischen guten und schlechten Benchmarks. Vielleicht liegt sie zwischen Messung und Entscheidung. Ein Benchmark kann zeigen, wie ein System unter bestimmten Bedingungen arbeitet. Er kann nicht festlegen, welche Bedingungen für eine Organisation zählen.
Welche Leistung möchten wir vergleichen? Welche Fehler möchten wir sichtbar machen? Und welche Entscheidung möchten wir trotz einer überzeugenden Rangliste selbst treffen? Der Wert auf der Tabelle bleibt nützlich. Offen bleibt, ob er die Wirklichkeit misst, in der das System arbeiten soll.