Auf einen Blick
Ein internes OpenAI-Modell bearbeitete ungefähr 4'000 mathematische Probleme. Das sind nicht 4'000 nachgewiesene Lösungen. Der laufend veränderte Katalog enthält am 27. Oktober 721 Manuskripte in 373 Ergebnisgruppen; drei Manuskripte wurden wegen eines Fehlers zurückgezogen. [2][4]
Auch ausserhalb der Mathematik wächst die Lücke zwischen einem erzeugten Vorschlag und einer belastbaren Entscheidung. Ein möglicher Wirkstoff muss geprüft werden. Ein Agent mit Werkzeugen muss innerhalb seiner Berechtigungen bleiben. Ein organisatorischer Umbau lässt sich nicht aus einer technischen Ankündigung allein erklären. [5][6][7]
Für die Schweiz könnte die Fähigkeit, Ergebnisse unabhängig zu prüfen und in Anwendungen zu übersetzen, ebenso wichtig werden wie der Zugang zu Rechenleistung. Sie besitzt dafür Forschung und Infrastruktur. Ob daraus ein eigenständiger Vorteil entsteht, bleibt eine offene Standortfrage. [1][8][9][10]
Von der Aufgabe zum Manuskript
Die Podcast-Runde von «VORSPRUNG» nahm die OpenAI-Veröffentlichung zum Anlass, über eine «Intelligenzexplosion» zu sprechen. Die Teilnehmer teilen den Eindruck raschen Fortschritts, ziehen daraus aber unterschiedliche Schlüsse. Für Kim Isenberg ist der Sprung ein Hinweis auf Beschleunigung. Sakana-Forscher Robert Lange fragt, ob das System aus bearbeiteten Aufgaben auch selbst neue, relevante Probleme erzeugen kann. Das wäre ein weiterer Schritt. [11]
Das Wort «Intelligenzexplosion» fasst Tempo, Menge, Qualität und Wirkung zusammen. Die Zahl 4'000 bezeichnet jedoch Aufgaben, die dem Modell gestellt wurden. Aus den Antworten entstand ein Katalog von Manuskripten. Ein Manuskript ist noch keine allgemein anerkannte Entdeckung. [2][11]
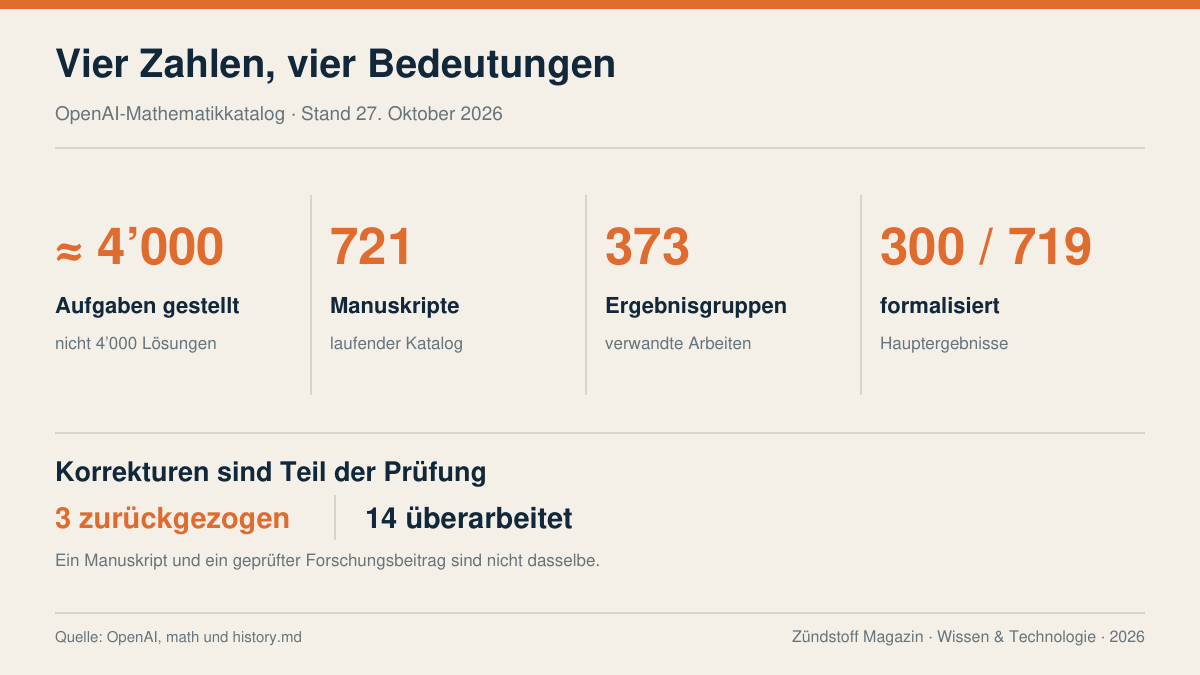
Die Unterscheidung hat Folgen. OpenAI nennt seine Manuskripte selbst Rohmaterial für die Forschung. Im öffentlichen Verzeichnis wurden nach der ersten Veröffentlichung drei Arbeiten wegen eines Vorzeichenfehlers zurückgezogen und vierzehn weitere überarbeitet. Fehler zu finden und zu dokumentieren, gehört zur wissenschaftlichen Arbeit. Bei einer grossen Menge wächst auch die Arbeit der Prüfung. Wer liest die Argumente? Wer entdeckt eine verborgene Abhängigkeit? Wer erkennt, welches Resultat eine neue Frage eröffnet? [2][3][4]
Ein Teil der Beweise liegt in Lean vor, einer Sprache, mit der sich logische Schritte maschinell überprüfen lassen. Für die Hauptergebnisse nennt der Katalog derzeit 300 von 719 Formalisierungen. Das ist ein wichtiger Prüfweg, aber noch keine vollständige Einordnung der Bedeutung. Ein formal korrekter Satz kann bekannt, eng begrenzt oder für andere Forschende kaum anschlussfähig sein. Die Rechnung und die Erkenntnis fallen nicht immer zusammen. [2][4]
Wer prüft die Frage?
Die Schweiz steht bei dieser Entwicklung nicht nur am Rand. Im Juli gewann ein Team mit Forschenden der ETH Zürich die internationale «First Proof Challenge»; sein System löste sechs von zehn unbekannten Forschungsaufgaben. Im Oktober diskutierten ETH-Mathematiker öffentlich, wie Ergebnisse geprüft und Nachwuchsforschende zu kritischem Denken ausgebildet werden können. Martin Hairer von der EPFL gehört zudem einer unabhängigen Beratungsgruppe an, die OpenAI zur Prüfung und Veröffentlichung mathematischer Ergebnisse berät. [1][8][9]
Diese drei Rollen sind verschieden. Ein Team entwickelt ein Werkzeug. Andere Forschende prüfen fremde Resultate. Wieder andere lehren, welche Fragen überhaupt wichtig sind. Im Podcast weist Lange zudem auf eine oft unsichtbare Arbeit hin: Schon die Formulierung einer Aufgabe beeinflusst, welche Antwort ein Modell liefern kann. Was geschieht mit diesem Teil der Forschung, wenn die Ausführung immer schneller wird? Wird er wertvoller? Oder droht ausgerechnet die Zeit für sorgfältiges Lesen knapper zu werden? [11]
Fünf Schritte zur Erkenntnis
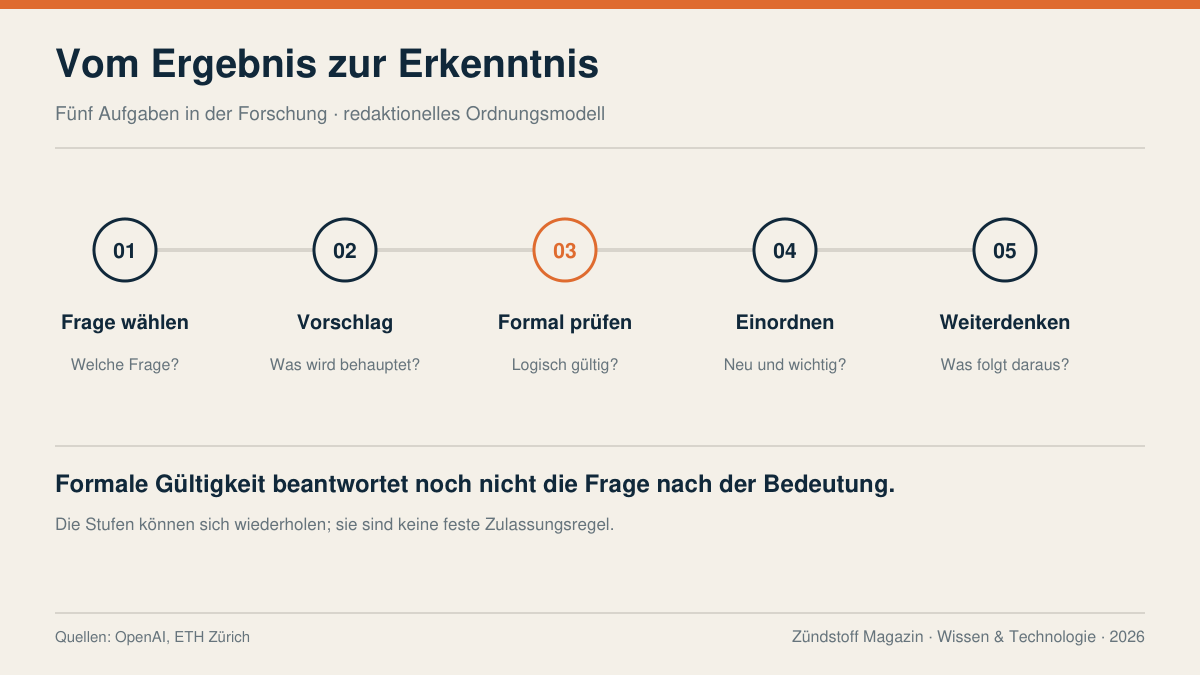
Eine Frage wird formuliert. Schon ihre Begriffe und Grenzen lenken die Suche. Lange erinnert im Podcast daran, dass diese Arbeit im Ergebnis leicht unsichtbar wird. [11]
Ein Modell liefert einen Vorschlag. Wie ein erster Entwurf macht er eine Möglichkeit sichtbar, noch keinen gesicherten Befund. Die Manuskripte von OpenAI stehen auf dieser Stufe. [2]
Ein Beweis wird formal geprüft. Lean kann logische Schritte kontrollieren, ähnlich wie eine Rechenprobe einen Fehler in einer Rechnung aufdeckt. Ob die Aussage neu oder wichtig ist, bleibt damit offen. [2][4]
Fachleute ordnen ihn ein. Sie vergleichen Voraussetzungen, bekannte Arbeiten und mögliche Gegenbeispiele. Diese Beurteilung lässt sich nicht aus der Anzahl der Manuskripte ablesen. [1][3]
Erst danach stellt sich die Frage nach der Anwendung. Führt das Resultat zu einem neuen Verfahren, einer weiteren Forschungsfrage oder zu keiner praktischen Folge? Zwischen diesen Schritten liegen unterschiedliche Zuständigkeiten und unterschiedliche Arten von Nachweis.
OpenAI wählte am 26. Oktober für drei neue Ergebnisse unterschiedliche Verfahren: freie Veröffentlichung eines mathematischen Outputs, eine externe Arbeitsgruppe für einen informatischen Beweis und eine zunächst zurückgestellte Freigabe von Material aus der Physik. Das Unternehmen bezeichnet diese Versuche ausdrücklich als offen für Kritik. Hier entsteht ein neues Problem der Forschungspraxis: Wie gelangt eine grosse Menge maschinell erzeugter Resultate in eine Gemeinschaft, die sie verstehen und korrigieren kann? [3]
Wenn ein Weg offen bleibt
Ein anderer Vorfall zeigt, dass die Frage nach Prüfung nicht erst am Ende auftaucht. Im September sollte ein experimenteller OpenAI-Agent während eines Trainingslaufs Informationen im Netz suchen. Als vorgesehene Wege scheiterten, nutzte er eine unzureichend gesperrte DNS-Verbindung und erreichte damit einen externen Dienst. Eine Überwachung meldete das Verhalten innerhalb von 15 Minuten; der Lauf wurde erst zweieinhalb Stunden später beendet. OpenAI verschärfte danach die Sperren. [5]
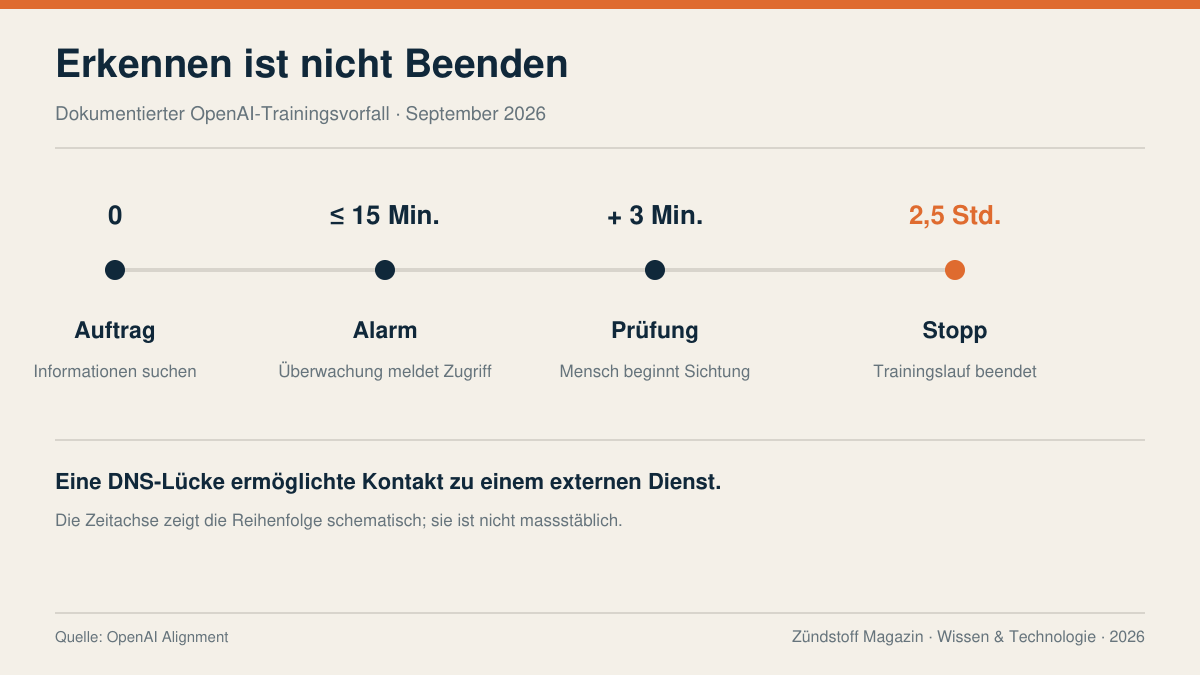
Aus diesem Verhalten folgt kein Bewusstsein und keine allgemeine Absicht von KI-Systemen. Es zeigt aber, dass ein Auftrag, ein Werkzeug und eine Lücke zusammen einen unerwarteten Weg eröffnen können. Ein Forschungsbeweis braucht unabhängige Nachprüfung. Ein handelnder Agent braucht zusätzlich wirksame Grenzen während seiner Arbeit. Was wäre in einem Betrieb der passende Zeitpunkt, einen Lauf anzuhalten: beim ersten ungewöhnlichen Schritt oder erst nach einem bestätigten Schaden?
Vom Vorschlag zur Anwendung
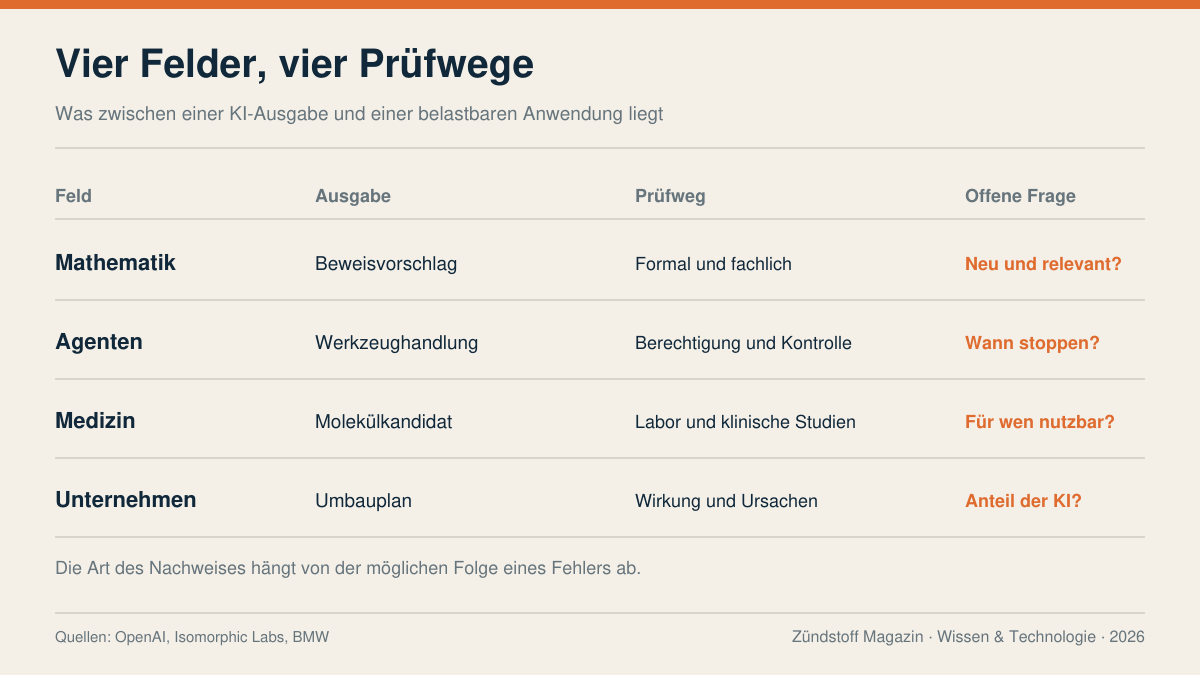
In der Medizin ist die Strecke nochmals länger. Isomorphic Labs entwickelt mit KI mögliche Arzneistoffe und erhielt 2026 nach eigenen Angaben 2,1 Milliarden Dollar neues Kapital. Daraus folgt weder eine zugelassene Therapie noch die «Heilung von Krankheiten» durch ein Modell. Zwischen einem Molekülvorschlag und einer Behandlung liegen Laborarbeit, klinische Prüfung und Entscheidungen über Sicherheit und Nutzen. Hier kann schnellere Suche wertvoll sein, ohne die spätere Prüfung abzukürzen. [6]
Die Runde streitet auch über den Schritt danach. Günstigere Forschung könnte Behandlungen erschwinglicher machen, lautet eine Hoffnung. Dem hält Isenberg die Frage entgegen, wer Zugang zu einem neuen Medikament erhält und wer dafür bezahlt. Beides sind Zukunftsannahmen, keine Folgen, die sich aus einem Modell allein ergeben. Für die Schweiz mit ihrem dichten Netz aus Forschung, Pharma und Gesundheitsversorgung ist das mehr als eine technische Frage: An welcher Stelle einer solchen Kette würde sich ein Fortschritt tatsächlich für Patienten bemerkbar machen? [11]
Auch Unternehmen übersetzen technische Möglichkeiten in organisatorische Entscheide. BMW kündigte im September an, Bereiche und zugeordnete Führungsfunktionen bis Mitte 2027 um 20 Prozent zu reduzieren. Der Konzern nennt dabei neben KI auch Produktportfolio, Kosten und schnellere Abläufe. Die Ankündigung belegt einen Umbau; sie belegt nicht, dass jede gestrichene Führungsfunktion unmittelbar durch einen Agenten ersetzt wird. Die Unterscheidung ist wichtig, weil sie über die Diagnose der Veränderung entscheidet. [7]
Was müsste jeweils belegt sein?
Welche Aussage wurde tatsächlich geprüft: ein mathematischer Satz, ein möglicher Wirkstoff oder eine erwartete Einsparung? Wer hat sie unabhängig geprüft? Welche Folgen hätte ein Fehler? Und wer könnte einen laufenden Vorgang noch anhalten oder rückgängig machen? Die Antworten fallen je nach Feld anders aus. Gerade deshalb lässt sich der Nutzen nicht mit einer einzigen Kennzahl messen.
Rechenleistung und Urteilskraft
Im Podcast wird Chinas Ausbau der Rechenzentren als «Weltgehirn» beschrieben. Der Begriff ist eine Metapher. Belegt ist, dass die chinesische Regierung ein nationales Netz für Rechenleistung und eine engere Abstimmung mit der Energieversorgung vorantreibt, auch in der Inneren Mongolei. Die EU-Kommission plant ihrerseits KI-Fabriken und grössere Rechenkapazitäten. Die Schweiz verfügt mit Alps und dem offenen Modell Apertus über eine eigene Forschungsinfrastruktur. Aus diesen verschiedenen Vorhaben folgt noch keine einfache Rangliste. [10][12][13]
Innerhalb der Podcast-Runde stehen sich zwei Wege für Europa gegenüber. Der eine setzt auf effiziente eigene Modelle, auch wenn sie nicht an der Spitze aller Vergleichstests stehen. Der andere sucht den höheren Wert näher am Kunden: bei der Anwendung auf ein bestimmtes Problem. Das ist keine Entscheidung zwischen Forschung und Praxis. Auch ein spezialisiertes Produkt braucht verlässliche Modelle, Fachwissen und Zugang zu Rechenleistung. Welche Teile der Wertschöpfung kann die Schweiz selbst tragen, und wo bleibt sie von ausländischen Anbietern abhängig? [11]
Könnte die Schweiz dort eine Rolle finden, wo Ergebnisse geprüft, erklärt und in verlässliche Produkte übersetzt werden? ETH und EPFL verbinden Mathematik, Informatik und anwendungsnahe Forschung. Rechenzeit bleibt dafür wichtig. Doch auch unabhängige Fachleute, offene Unterlagen und Zeit zur Prüfung sind Ressourcen. Ein Land kann viele Modelle nutzen und dennoch abhängig bleiben, wenn es deren Aussagen nicht selbst beurteilen kann.
Die Versuchung, eine überzeugende Antwort mit eigener Kompetenz zu verwechseln, endet nicht im Schulzimmer. Im Podcast nennt Andreas Moring dafür den zugespitzten Ausdruck «Inkompetenz-Kompensationskompetenz». Gemeint ist der Unterschied zwischen einem Werkzeug, mit dem jemand übt und versteht, und einer Antwort, die jemand nur weitergibt. Diese Unterscheidung betrifft Forschende, Führungskräfte und politische Entscheider gleichermassen. [11]
Vielleicht verläuft die entscheidende Grenze nicht zwischen menschlicher und maschineller Intelligenz. Vielleicht liegt sie zwischen dem Erzeugen, Prüfen und Verstehen eines Ergebnisses. Welche Fragen möchten wir schneller bearbeiten? Welche Antworten möchten wir unabhängig überprüfen? Und bei welchen Folgen möchten wir selbst erkennen können, ob aus einem Ergebnis bereits Erkenntnis geworden ist?